
PEFT documentation
BOFT
BOFT
Orthogonal Butterfly (BOFT) là một phương pháp tổng quát được thiết kế để tinh chỉnh các mô hình nền tảng. Nó cải thiện hiệu quả tham số của quy trình tinh chỉnh — Orthogonal Finetuning (OFT), bằng cách lấy cảm hứng từ biến đổi Fourier nhanh Cooley-Tukey, cho thấy kết quả khả quan khi tinh chỉnh các mô hình nền tảng khác nhau, bao gồm các vision transformer lớn, các mô hình ngôn ngữ lớn và các mô hình khuếch tán từ văn bản sang hình ảnh.
Tóm tắt từ bài báo là:
Các mô hình nền tảng lớn đang trở nên phổ biến, nhưng việc huấn luyện chúng từ đầu lại có chi phí quá cao. Do đó, việc thích ứng hiệu quả các mô hình mạnh mẽ này cho các tác vụ hạ nguồn ngày càng trở nên quan trọng. Trong bài báo này, chúng tôi nghiên cứu một phương pháp tinh chỉnh có nguyên tắc — Tinh chỉnh trực giao (OFT) — cho việc thích ứng tác vụ hạ nguồn. Mặc dù thể hiện khả năng khái quát hóa tốt, OFT vẫn sử dụng một số lượng tham số có thể huấn luyện khá lớn do tính đa chiều cao của các ma trận trực giao. Để giải quyết vấn đề này, chúng tôi bắt đầu bằng cách xem xét OFT từ góc độ truyền tải thông tin, sau đó xác định một số yêu cầu chính giúp đạt được hiệu quả tham số tốt hơn. Lấy cảm hứng từ cách thuật toán biến đổi Fourier nhanh Cooley-Tukey cho phép truyền tải thông tin hiệu quả, chúng tôi đề xuất một tham số hóa trực giao hiệu quả sử dụng cấu trúc bướm. Chúng tôi áp dụng tham số hóa này vào OFT, tạo ra một phương pháp tinh chỉnh hiệu quả về tham số mới, được gọi là Bướm trực giao (BOFT). Bằng cách bao hàm OFT như một trường hợp đặc biệt, BOFT giới thiệu một khung tinh chỉnh trực giao tổng quát. Cuối cùng, chúng tôi tiến hành một nghiên cứu thực nghiệm rộng rãi về việc thích ứng các biến đổi thị giác lớn, các mô hình ngôn ngữ lớn và các mô hình khuếch tán từ văn bản sang hình ảnh cho nhiều tác vụ hạ nguồn khác nhau trong thị giác và ngôn ngữ.
BOFT tập trung vào việc bảo toàn khả năng sinh của mô hình được huấn luyện trước, đồng thời đạt hiệu quả tham số cao hơn đáng kể so với OFT tiêu chuẩn. Giống như OFT, BOFT duy trì cùng một độ tương đồng cosine (năng lượng siêu cầu) giữa tất cả các cặp neuron trong một lớp bằng cách áp dụng phép biến đổi trực giao lên ma trận trọng số đã được huấn luyện trước, đảm bảo các mối quan hệ ngữ nghĩa giữa các neuron được bảo toàn.
Thay vì sử dụng một ma trận trực giao dạng khối chéo, BOFT phân tích phép biến đổi trực giao thành tích của các ma trận bướm thưa (ban đầu được giới thiệu trong Cooley–Tukey FFT). Khác với các phép quay dạng khối chéo của OFT, vốn chỉ trộn lẫn các đầu vào trong từng khối, cấu trúc bướm đảm bảo rằng mọi đầu vào đều có thể ảnh hưởng đến mọi đầu ra, tạo ra sự kết nối dày đặc với chỉ O(d log d) tham số. Việc phân tích này giữ nguyên khả năng biểu diễn trong khi giảm đáng kể số lượng tham số so với OFT (với cái giá là thời gian tính toán).
Trong thực tế, BOFT nhân mỗi ma trận trọng số đã được huấn luyện trước với một chuỗi các nhân tử trực giao có cấu trúc bướm, cho phép thực hiện các phép xoay neuron hiệu quả và biểu cảm. Điều này khiến BOFT phù hợp cho các tác vụ sinh có thể kiểm soát và các nhiệm vụ mà việc duy trì biểu diễn chủ đề của mô hình đã được huấn luyện trước là yếu tố then chốt, đồng thời có thể mở rộng sang các mô hình lớn hơn với chi phí bộ nhớ và tính toán thấp hơn.
BOFT có thể được áp dụng cho bất kỳ tập con nào của các ma trận trọng số trong mạng nơ-ron để giảm số lượng tham số có thể huấn luyện. Với các lớp đích để tiêm các tham số BOFT, số lượng tham số có thể huấn luyện có thể được xác định dựa trên kích thước của các ma trận trọng số.
Tổng quan về benchmark
Gộp trọng số BOFT vào mô hình cơ sở
Tương tự như LoRA, các trọng số được học bởi BOFT có thể được tích hợp vào các ma trận trọng số đã được huấn luyện trước bằng cách sử dụng hàm [~BOFTModel.merge_and_unload(). Hàm này kết hợp trọng số của adapter với mô hình cơ bản, cho phép bạn sử dụng mô hình đã được kết hợp mới như một mô hình độc lập.
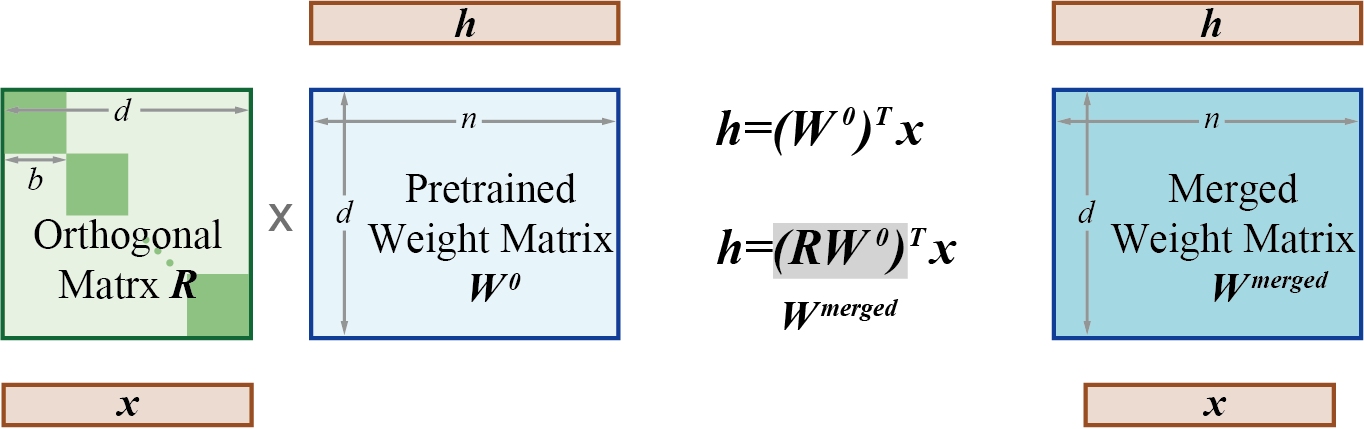
Điều này hoạt động vì trong quá trình huấn luyện, ma trận trọng số trực giao (R trong sơ đồ ở trên) và các ma trận trọng số được huấn luyện trước là tách biệt. Nhưng khi huấn luyện hoàn tất, các trọng số này thực sự có thể được gộp (nhân) lại thành một ma trận trọng số mới tương đương.
Ví dụ sử dụng BOFT
Để xem một ví dụ về việc áp dụng phương pháp BOFT cho các tác vụ downstream khác nhau, vui lòng tham khảo các hướng dẫn sau:
Hãy xem các hướng dẫn từng bước sau đây về cách tinh chỉnh một mô hình với BOFT:
Đối với tác vụ phân loại hình ảnh, bạn có thể khởi tạo cấu hình BOFT cho một mô hình DinoV2 như sau:
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
lớp peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
Tham số
- boft_block_size (
int) — Kích thước khối ma trận BOFT giữa các lớp khác nhau, được biểu diễn bằngint. Kích thước khối lớn hơn sẽ dẫn đến các ma trận cập nhật đặc hơn với nhiều tham số có thể huấn luyện hơn. Hãy chọnboft_block_sizesao cho chia hết cho chiều đầu vào (in_features) của hầu hết các lớp, ví dụ: 4, 8, 16. Ngoài ra, vui lòng chỉ chỉ địnhboft_block_sizehoặcboft_block_num, nhưng không chỉ định cả hai cùng lúc hoặc để cả hai bằng 0, vìboft_block_sizexboft_block_numphải bằng chiều đầu vào của lớp. - boft_block_num (
int) — Số lượng khối BOFT trên mỗi lớp được tiêm.boft_block_numlớn hơn sẽ tạo ra các ma trận cập nhật thưa hơn với ít tham số có thể huấn luyện hơn. Lưu ý, hãy chọnboft_block_numsao cho chia hết cho chiều đầu vào của hầu hết các lớp (in_features), ví dụ: 4, 8, 16. Chỉ nên chỉ địnhboft_block_sizehoặcboft_block_num, không nên chỉ định cả hai cùng lúc hoặc để cả hai bằng 0, vìboft_block_sizexboft_block_numphải bằng chiều đầu vào của lớp. - boft_n_butterfly_factor (
int) — Số lượng các nhân tử butterfly giữa các lớp khác nhau. Vớiboft_n_butterfly_factor=1, BOFT giống hệt OFT thông thường, còn vớiboft_n_butterfly_factor=2, kích thước khối hiệu dụng của OFT sẽ tăng gấp đôi và số lượng khối giảm đi một nửa. - target_modules (
Union[List[str],str]) — Tên của các module cần áp dụng adapter. - exclude_modules (
Optional[Union[List[str], str]]) — Tên của các module không áp dụng adapter. Khi truyền một chuỗi, một phép khớp regex sẽ được thực hiện. Khi truyền một danh sách các chuỗi, một phép khớp chính xác sẽ được thực hiện hoặc kiểm tra xem tên của module có kết thúc bằng bất kỳ chuỗi nào được truyền vào hay không. - boft_dropout (
float) — Xác suất dropout nhân, bằng cách đặt các khối OFT thành hằng đẳng trong quá trình huấn luyện, tương tự như lớp dropout trong LoRA. - fan_in_fan_out (
bool) — Đặt giá trị này thành True nếu lớp cần thay thế lưu trọng số theo dạng (fan_in, fan_out). Ví dụ, gpt-2 sử dụngConv1D, lưu trọng số theo dạng (fan_in, fan_out), do đó cần đặt giá trị này thànhTrue. - bias (
str) — Bias type for BOFT. Can be ‘none’, ‘all’ or ‘boft_only’. If ‘all’ or ‘boft_only’, the corresponding biases will be updated during training. Be aware that this means that, even when disabling the adapters, the model will not produce the same output as the base model would have without adaptation. - modules_to_save (
List[str]) —Danh sách các module ngoài các lớp BOFT cần được đặt là có thể huấn luyện và lưu trong checkpoint cuối cùng. - layers_to_transform (
Union[List[int],int]) — Các chỉ số lớp cần biến đổi. Nếu tham số này được chỉ định, các phép biến đổi BOFT sẽ được áp dụng lên các chỉ số lớp được liệt kê trong danh sách này. Nếu một số nguyên duy nhất được truyền vào, phép biến đổi BOFT sẽ được áp dụng lên lớp tại chỉ số đó. - layers_pattern (
Optional[Union[List[str], str]]) — Tên mẫu lớp, chỉ được sử dụng nếulayers_to_transformkhácNonevà nếu mẫu lớp không nằm trong các mẫu lớp phổ biến. Tham số này nên nhắm đếnnn.ModuleListcủa mô hình, thường được gọi là'layers'hoặc'h'.
Đây là lớp cấu hình để lưu trữ cấu hình của BOFTModel.
BOFTModel
lớp peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Tham số
- model (transformers.PreTrainedModel) — Mô hình cần được thích ứng.
- config (BOFTConfig) — Cấu hình của mô hình BOFT.
- adapter_name (
str) — Tên của adapter, mặc định là"default". - low_cpu_mem_usage (
bool,optional, mặc định làFalse) — Tạo trọng số adapter rỗng trên thiết bị meta. Hữu ích để tăng tốc quá trình tải.
Trả về
torch.nn.Module
Mô hình BOFT.
Tạo mô hình BOFT và OFT từ một mô hình transformers đã được huấn luyện trước. Bài báo: https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
Ví dụ:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)
Thuộc tính:
- model (transformers.PreTrainedModel) — Mô hình cần được thích ứng.
- peft_config (BOFTConfig): Cấu hình của mô hình BOFT.